Turf: caballos, datos y predicciones
Un proyecto de datos aplicado al turf: recolección automática de próximas reuniones, modelos predictivos y monitoreo para mantener el sistema funcionando día a día.
Turf reúne datos históricos de carreras y genera predicciones con un nivel de confianza. El sistema busca próximas reuniones, recoge los antecedentes de los caballos y publica los análisis en la web. Lo construí después de empezar a frecuentar el hipódromo, en una época en la que todavía estaba aprendiendo cómo funcionaba ese mundo.
Las primeras visitas al hipódromo
A principios de 2026, mi novia había comprado un caballo de carreras y fuimos al hipódromo para recibirlo. Me sorprendió verlo de cerca: su tamaño, la musculatura y la docilidad con la que se movía alrededor de las personas. Durante las semanas siguientes empezamos a ir más seguido. Lo veía entrenar y correr, y aprovechaba las visitas para hablar con entrenadores y cuidadores.
Algunos llevaban décadas en el turf y podían observar un caballo unos segundos y dar una opinión sobre sus posibilidades. Esa experiencia incluía información difícil de encontrar en una base de datos. Me interesó probar cuánto podía acercarme a sus estimaciones usando los datos públicos disponibles. Esa curiosidad dio origen al proyecto.
Conseguir y mantener los datos
La información estaba repartida entre fuentes con formatos y niveles de calidad distintos. Una parte se podía consultar mediante APIs; para el resto tuve que hacer scraping, es decir, extraer los datos de las páginas donde se publicaban.
En pocas horas tenía una primera versión que recolectaba información. Mantenerla funcionando llevó más trabajo: había que detectar cambios en las páginas, respetar los límites de consultas y conservar la consistencia de los datos. Una consulta fallida tampoco podía obligarme a repetir todo el proceso.
Organicé la recolección en etapas que pudieran ejecutarse y revisarse por separado. Eso fue dando forma al proyecto como sistema de datos y terminó ocupando una parte importante del desarrollo.
La carga automática de reuniones
Los procesos programados revisan el calendario en busca de nuevas reuniones. Cuando encuentran una, recogen las carreras y sus participantes, buscan los antecedentes de los caballos y reintentan las consultas fallidas. Después generan las predicciones y publican la reunión en la web. Ya no tengo que cargar cada jornada a mano.
Una vez disputadas las carreras, otro proceso recoge los resultados disponibles y vuelve sobre los que siguen pendientes. Esos datos permiten comparar las predicciones con lo que ocurrió.
Monitoreo de los procesos y del modelo
Necesitaba comprobar que la información siguiera llegando, incluso cuando la web parecía funcionar bien. Armé un panel con las últimas ejecuciones de los procesos, las próximas tareas y los resultados pendientes. Un semáforo resume si hay algo que revisar.
El sistema también controla la conexión a la base de datos, el espacio disponible y las tareas que quedaron colgadas. Puede avisarme por Telegram cuando detecta anomalías, y tiene rutinas programadas de mantenimiento y copias de seguridad.
En el mismo panel sigo los aciertos del modelo. La tabla agrupa las carreras por nivel de confianza y muestra cuántas veces ganó la primera selección y cuántas el ganador estuvo entre las dos primeras.
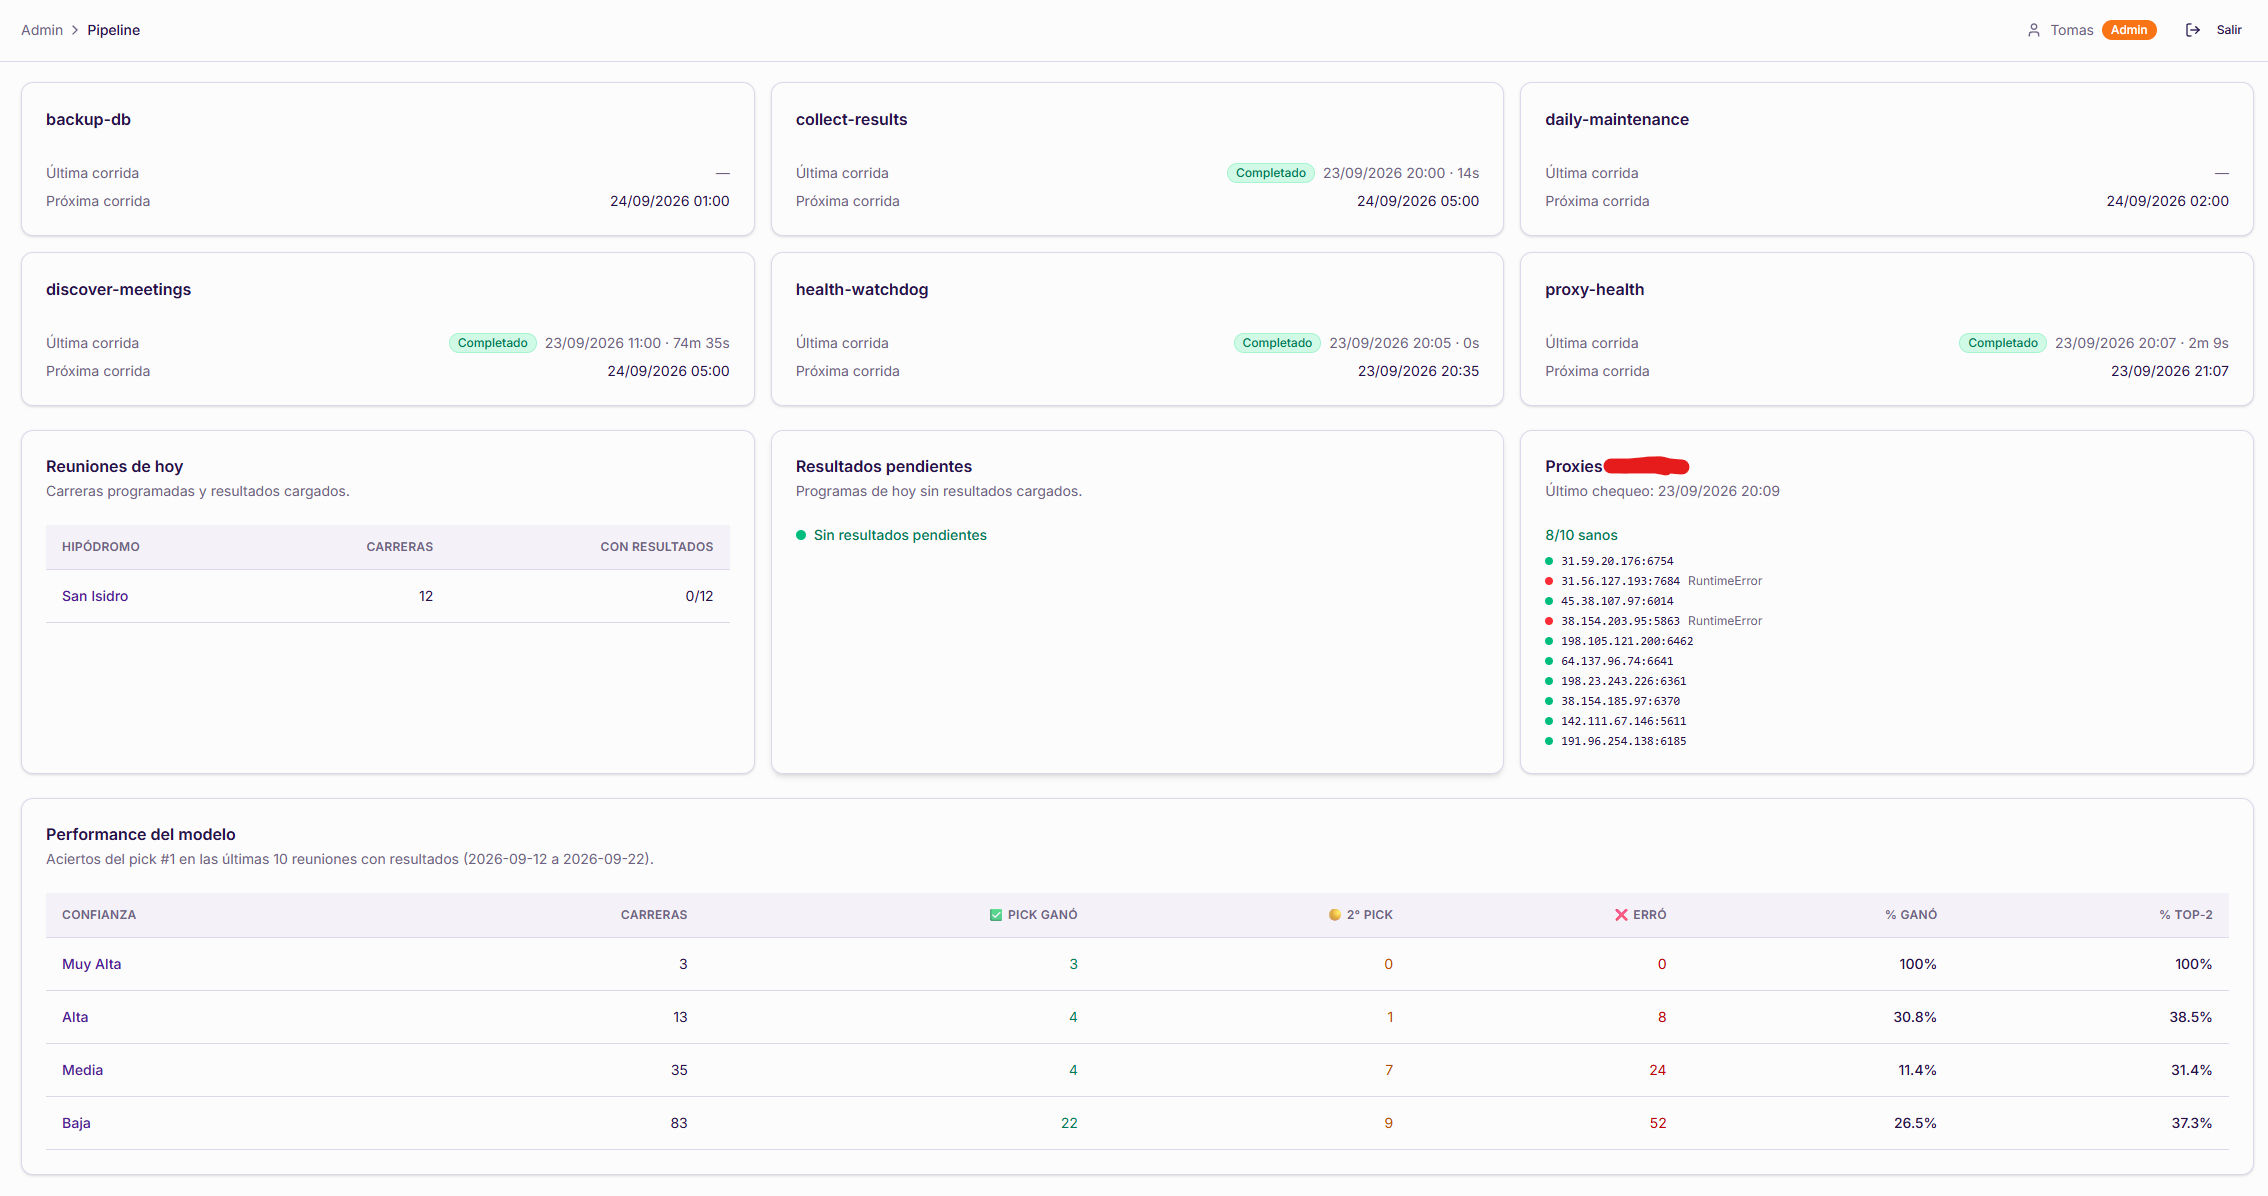
Captura del 23 de septiembre de 2026. La tabla resume las últimas diez reuniones con resultados: el grupo de confianza “Muy alta” muestra tres aciertos en tres carreras, una muestra pequeña dentro de ese período. Abrir imagen en tamaño completo.
Elegir las variables
Trabajé con más de 8.000 carreras en total, repartidas entre los conjuntos de entrenamiento y de prueba. Uno de los mayores desafíos fue reducir lo más posible la varianza del modelo: que su comportamiento dependiera menos de las particularidades de las carreras usadas para entrenarlo y fuera más estable al evaluar otras.
Al principio agregaba datos con la expectativa de mejorar las predicciones. Algunas variables daban mejores resultados sobre las carreras históricas, pero empeoraban el rendimiento cuando el modelo analizaba carreras nuevas. Era un problema de sobreajuste: estaba ajustando demasiado el modelo a los ejemplos que ya conocía.
El principio de Pareto me sirvió como criterio para concentrarme en los factores que más aportaban. Reduje la cantidad de variables y busqué un comportamiento más consistente, aunque eso implicara dejar de perseguir algunas mejoras pequeñas en las pruebas históricas.
La confianza de cada predicción
Hay información que el modelo no tiene. Durante los entrenamientos se toman tiempos manualmente, se observa el estado físico de los caballos y se habla con sus entrenadores. Parte de eso puede cambiar la evaluación de una carrera sin llegar a publicarse de forma estructurada.
Por eso, junto con la selección de un posible ganador, el sistema calcula un nivel de confianza. Las carreras con muchos debutantes o pocos antecedentes reciben una confianza baja. Cuando hay suficiente información comparable, la confianza es mayor. Esta clasificación me permite distinguir las predicciones según la información que las respalda.
Las herramientas
Usé Python y FastAPI para el backend. Celery ejecuta tareas en segundo plano y Prefect organiza los procesos programados y registra sus ejecuciones. Esa separación me permite revisar una etapa o volver a ejecutarla sin depender de una secuencia de pasos manuales.
Para la web elegí Next.js. No soy desarrollador frontend, así que fue una de las partes que más me costaron. Trabajé durante casi todo el desarrollo con agentes de IA mediante Kimi Code, primero en la versión 2.6 y después en la 2.7. Me ayudaron a acelerar la implementación y a dedicar más tiempo al algoritmo y a las decisiones de arquitectura.
Estado actual
Después de miles de simulaciones y carreras analizadas, considero que el modelo tiene una precisión suficiente para esta versión. En la página de inicio se pueden consultar las métricas de evaluación sobre carreras que no se usaron para entrenarlo.
Podría seguir probando variables y ajustando parámetros, pero decidí dedicar más atención a la calidad de los datos y al funcionamiento diario. La versión está completa y la recolección es automática; sigo teniendo que revisar incidencias y adaptar los procesos cuando cambian las fuentes.
Conclusiones
Al revisar la rentabilidad, calculé que en el esquema que analicé la casa se queda con alrededor del 30% de lo apostado. Ese margen hace difícil obtener un rendimiento positivo. Acertar seguido puede no alcanzar si los caballos elegidos pagan dividendos bajos.
Con datos públicos, el mejor rendimiento que pude conseguir en las simulaciones fue apenas positivo. Para mí, compensar ese margen del 30% ya es un resultado valioso, aunque no garantiza que se repita en carreras futuras.
El grupo de carreras con confianza “Muy alta” mostró un porcentaje de aciertos especialmente alto en mis pruebas. Es un grupo muy reducido, y el panel permite ver esa limitación junto al porcentaje: en la captura hay tres aciertos, pero solo tres carreras. Me interesa seguir observándolo sin confundir esa tasa de aciertos con una medida de rentabilidad.
Además de los resultados del modelo, me queda un sistema que carga reuniones, procesa antecedentes y recoge resultados sin que tenga que iniciar cada paso. Puedo revisar sus ejecuciones y detectar dónde se interrumpió el trabajo. Esa parte del proyecto es la que hoy me permite mantenerlo en funcionamiento.
¿Te gustó? Sigue mis actualizaciones en RSS. Sígueme por RSS